Hallusinasjoner i språkmodeller
Hvordan en språkmodell kan gi deg en god forklaring på noe som aldri har skjedd, og hva du kan gjøre for å oppdage det.
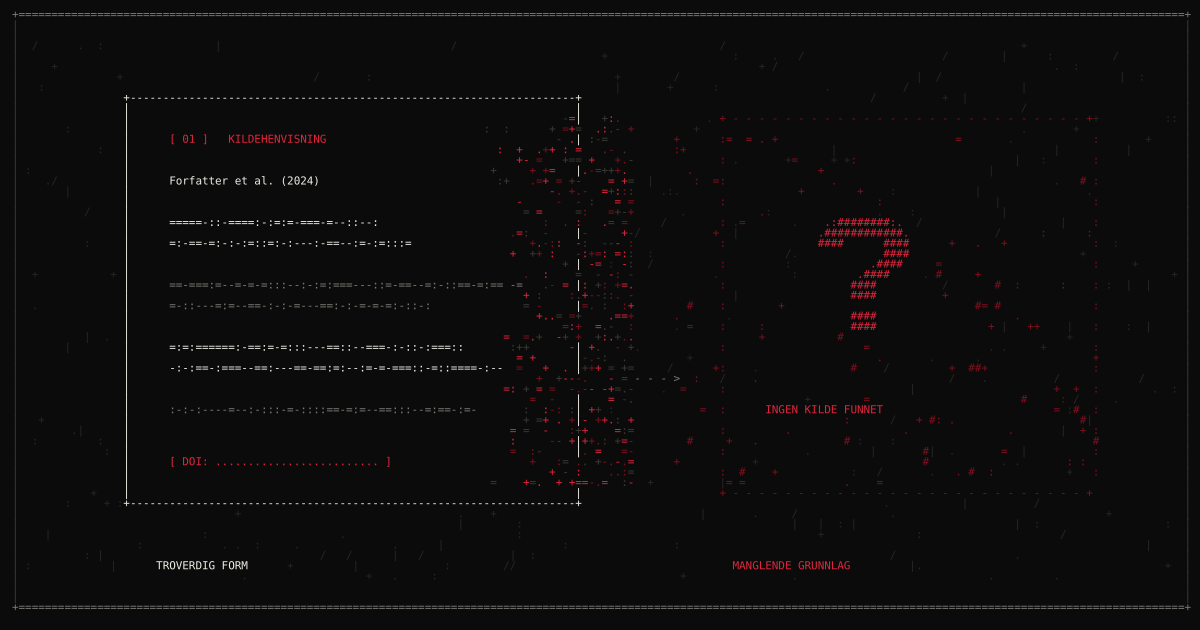
Du ber en språkmodell finne forskning på et tema. Den svarer med en relevant artikkel, komplett med forfattere, årstall og et kort sammendrag. Du søker opp tittelen. Artikkelen finnes ikke.
Likevel så svaret helt vanlig ut. Ingenting i språket fortalte deg at referansen var oppdiktet. Og hadde du ikke sjekket, kunne den fort blitt med inn i det du jobbet med.
Dette er en av de vanligste måtene vi møter hallusinasjoner på. Så hvorfor skjer det, og hvordan kan vi fange dem før vi bruker svaret videre?
Hva vi mener med hallusinasjoner
Når en språkmodell presenterer oppdiktet eller udokumentert innhold som fakta, kaller vi det gjerne en hallusinasjon. Det kan være en person som aldri har eksistert, en kilde som ikke finnes, eller en detalj modellen har lagt til i et sammendrag.
Hele svaret trenger ikke være feil. Et sammendrag kan gjengi innholdet godt, men legge til et navn eller et tall som aldri sto i teksten. Den ene detaljen ser akkurat like troverdig ut som resten.
Det er dette som gjør hallusinasjoner vanskelige å oppdage. Språket gir oss ikke noen sikker måte å skille dem fra riktige svar på.
Når modellen får en tekst å jobbe med, brukes ofte et skille mellom to typer feil. Den kan motsi teksten, for eksempel skrive 2020 når kilden sier 2019. Eller den kan legge til noe teksten ikke sier, som et navn som ikke står der. Det siste trenger ikke være usant ute i verden, men modellen har ikke grunnlag i dokumentet for å påstå det.
For deg som ba om et sammendrag, er begge deler et problem. Du forventer at sammendraget gjengir det som står der.
Modellen kan formen på svaret
En språkmodell genererer tekst ved å velge neste token, altså en liten bit av tekst, ut fra konteksten og mønstrene den har lært. Vil du gå dypere i selve prosessen, har jeg forklart den i Hvordan språkmodeller fungerer.
En forskningsreferanse har et gjenkjennelig mønster: forfattere, årstall, tittel og tidsskrift. Modellen kan ha lært dette mønsteret godt, og sette sammen en troverdig referanse selv om den mangler den faktiske kilden. Både den riktige og den oppdiktede referansen produseres token for token.
Det betyr ikke at modellen aldri kan oppdage en feil eller uttrykke usikkerhet. Det kan den. Men selve det at teksten blir generert, innebærer ingen garanti for at påstandene er kontrollert mot virkeligheten.
Riktig form er ikke nok
[ Tittel på en studie ]
[ Tidsskrift ]
Støtter den påstanden?
Noen opplysninger kan du ikke resonnere deg frem til
Du kan regne ut et gjennomsnitt fra tallene i en rapport. Men hvis rapporten mangler navnet på forfatteren, kan du ikke regne deg frem til det. Den opplysningen må hentes et sted.
Dette skillet er nyttig når du bruker AI. Mer resonnering kan hjelpe modellen med å bruke informasjonen den har, men tilfører ikke nødvendigvis opplysningene den mangler.
For en språkmodell kan problemet være at opplysningen nesten ikke forekom i treningsdataene. Eller at den forekom i flere versjoner som motsier hverandre. Eller at det som var riktig da modellen ble trent, har endret seg.
En modell har vanligvis en oppgitt grense for hvor fersk treningskunnskapen er, ofte kalt knowledge cutoff. Det er verken en garanti for at modellen kan alt før den datoen, eller et hinder for å bruke nyere informasjon du legger ved eller lar den hente. Men modellen får ikke automatisk vite om gårsdagens endringer bare fordi du spør om dem i dag.
Hvorfor svarer den likevel
En språkmodell kan svare «det vet jeg ikke». Så hvorfor får vi fortsatt så mange svar med detaljer den ikke har dekning for?
Noe av forklaringen ligger i hvordan modellene utvikles og vurderes. Kalai og kolleger viser i Why Language Models Hallucinate hvordan tester som gir uttelling for riktige svar, men ingen uttelling for å avstå, favoriserer gjetting.
Se for deg en prøve med fire svaralternativer. Du aner ikke hvilket som er riktig. Et tomt felt gir null poeng. Et tilfeldig kryss gir deg en sjanse til å få poenget. Da er det ganske fornuftig å gjette.
En modell som svarer på alt, kan dermed få flere riktige svar enn en mer forsiktig modell, samtidig som den gir langt flere feil. En god plassering på resultatlisten forteller ikke nødvendigvis hvor trygg modellen er å stole på når den først svarer. Forskerne argumenterer derfor for vurderinger som gir bedre uttelling for å avstå når grunnlaget mangler. Les studien og forklaringen fra OpenAI.
Det er også forskjell på et svar folk liker, og et svar som stemmer. Etter grunntreningen tilpasses modeller blant annet med tilbakemeldinger om hvilke svar som er gode. I metoder som RLHF brukes menneskelige vurderinger til å forme en belønning som modellen trenes mot. Hva vi faktisk belønner, har derfor betydning.
Hvis vurderingen favoriserer hjelpsom tone og tilsynelatende komplette svar uten å fange faktafeilene, kan feilene følge med videre. Det betyr ikke at all slik trening gjør modeller mindre ærlige. Den kan også brukes til å belønne usikkerhet og korrigering av feil. Poenget er at «dette svaret likte jeg» og «dette svaret har jeg kontrollert» er to forskjellige vurderinger. Giskards Phare-analyse illustrerer nettopp at brukerpreferanse og motstand mot hallusinasjoner ikke nødvendigvis følger hverandre. Giskard, 2025.
En feil kan bli starten på resten av svaret
Hvert token modellen skriver, blir en del av konteksten for det neste. Hvis den først oppgir et feil årstall, kan resten av forklaringen bli bygget rundt det. Én feil blir dermed utgangspunktet for flere påstander som passer sammen, men ikke stemmer.
Modellen kan oppdage problemet og korrigere seg senere i svaret eller i en ny runde. Men det skjer ikke automatisk. Den tidligere feilen er fortsatt en del av det den får se når den skal fortsette.
Du kan også legge inn den første feilen selv. Hvis du ber modellen forklare funnene i en studie som ikke finnes, ligger det allerede en feil antakelse i spørsmålet. Modellen kan spille med og gi deg en forklaring, i stedet for å påpeke problemet.
Prøv derfor å skille mellom det du vet, og det du vil ha undersøkt. Be modellen finne studien før du ber den forklare resultatene.
En feil får følge
Kilden sier 2019.
Resten av teksten ser årstallet.
Forklaringen bygges videre på feilen.
Når oppdiktede kilder blir brukt på ordentlig
I den amerikanske saken Mata v. Avianca leverte advokater inn rettsdokumenter med henvisninger til ikke-eksisterende avgjørelser som ChatGPT hadde produsert. De oppdiktede avgjørelsene kom med sitater og kildehenvisninger. Retten ila sanksjoner i juni 2023. Dette er beskrevet i selve rettsavgjørelsen.
Legg merke til hva slags feil dette var. Referansene var detaljerte nok til å se brukbare ut. En leser måtte faktisk undersøke dem for å finne problemet. At teksten lignet juridisk arbeid, var ikke tilstrekkelig.
Damien Charlotin vedlikeholder en database over rettssaker med AI-hallusinasjoner. Den gir flere konkrete eksempler, men antallet registrerte saker er ikke en måling av hvor ofte en språkmodell hallusinerer. Det påvirkes også av hvor mye AI brukes, hvilke feil som oppdages, og hvilke saker som blir dokumentert.
Hvor ofte skjer det
Du finner mange tester som sammenligner modeller. De er nyttige, men du må se på hva som faktisk ble testet.
Skulle modellen svare på faktaspørsmål fra treningskunnskapen sin? Oppsummere vedlagte dokumenter? Bruke nettsøk? Fikk den lov til å la være å svare? Teller testen feil per påstand eller per svar?
Det er ganske forskjellige oppgaver og mål.
Tenk deg to modeller som får 100 spørsmål. Den ene svarer riktig på 70, feil på 30 og hopper aldri over et spørsmål. Den andre svarer riktig på 65, feil på 5 og avstår fra 30.
Den første har flest riktige svar. Den andre gir deg langt færre feil å rydde opp i. Hvilken du foretrekker, avhenger av hva du skal bruke den til. Tallene her er et tenkt eksempel, men forskjellen er viktig når du leser resultatene fra en benchmark.
En nyere eller mer kapabel modell er heller ingen garanti for forbedring på akkurat din oppgave. Test på den typen materiale du faktisk skal bruke den på, også eksempler der svaret mangler. Ellers finner du ikke ut hva modellen gjør når den burde stoppe.
100 spørsmål og to ulike resultater
Du kan se etter ustabile svar
En enkel sjekk er å stille det samme spørsmålet flere ganger i separate samtaler og sammenligne faktaopplysningene. Får du forskjellige navn, datoer eller tall, har du en god grunn til å undersøke nærmere.
Dette er beslektet med ideen bak SelfCheckGPT: å bruke samsvar og motsetninger mellom flere genererte svar til å finne mulige hallusinasjoner. Forskerne testet metoden på modellgenererte biografier. Manakul og kolleger, 2023.
Men like svar beviser heller ikke at opplysningen stemmer. Modellen kan gjenta den samme feilen hver gang, og innstillingene kan gi lite variasjon i utgangspunktet. Derfor ville jeg brukt sprikende svar som et signal om å sjekke, og aldri like svar som en erstatning for en kilde.
Det hjelper heller ikke stort å spørre «er du helt sikker?» og ta et ja som bekreftelse. Du har bedt om enda et svar fra det samme systemet.
Enighet er ikke et bevis
Ulike fakta er et varselsignal.
Den samme feilen kan gjentas.
Legg informasjonen foran modellen
Har du rapporten eller dokumentasjonen spørsmålet gjelder, legg den ved. Da får modellen konkrete opplysninger å jobbe med, og du får noe å kontrollere svaret mot. Å knytte svaret til kildemateriale på denne måten kalles ofte grounding.
Be den gjerne hente ut det relevante sitatet før den svarer. Anthropic anbefaler både å tillate usikkerhet og å bruke direkte sitater som grunnlag for svar fra dokumenter. Anthropics veiledning om hallusinasjoner.
En slik bestilling kan se slik ut:
Finn og gjengi ordrette sitater fra dokumentet som besvarer spørsmålet. Svar deretter med utgangspunkt i sitatene. Hvis opplysningen mangler, skriv «Ikke oppgitt i dokumentet».
Da blir resultatet enklere å kontrollere. Du kan sammenligne sitatet med dokumentet, og sjekke om det faktisk støtter svaret. Et sitat kan også bli gjengitt feil eller tatt ut av sammenheng, så akkurat den kontrollen har fortsatt en jobb å gjøre.
Og husk hva kilden beviser. Modellen kan gjengi et referat riktig selv om referatet inneholder en feil. Skal du undersøke hva som faktisk skjedde, må kvaliteten på kilden også vurderes.
Gjør svaret mulig å kontrollere
Riktig dokument og versjon.
Hva står faktisk i teksten?
Støtter sitatet påstanden?
Hva modellen skal gjøre når noe mangler
«Ikke oppgitt» kan være akkurat det riktige svaret. Da har du fått vite at opplysningen må finnes et annet sted. Gjør dette til et vanlig, tillatt utfall i oppgaven du gir modellen. Det er også et av rådene i Anthropics dokumentasjon.
For de som bygger applikasjoner, gjelder dette også svarformatet. Se for deg at du skal hente et budsjett fra et dokument, og systemet krever dette feltet:
budsjett_kroner: tall
Du har gitt modellen et påkrevd tallfelt, men dokumentet inneholder ikke tallet. Nå er det en konflikt mellom å levere et gyldig format og å gjengi kilden korrekt. Et strengt format kan sikre at verdien er et tall. Det kan ikke sikre at tallet er sant.
La feltet godta en manglende verdi, og skill gjerne mellom informasjon som ikke er oppgitt og informasjon som er uklar. Når beløpet mangler, kan resultatet være:
{
  "budsjett_kroner": null,
  "budsjett_status": "ikke_oppgitt"
}
Dette er et forenklet eksempel på output. I en applikasjon må også schemaet, altså reglene for formatet, tillate null. Ellers har du bare gitt modellen lov til noe systemet ditt fortsatt avviser.
Ikke bruk null kroner som erstatning for ukjent budsjett. Da har du gjort en manglende opplysning om til en konkret påstand.
La den hente det den trenger
Noen ganger har du ikke kilden tilgjengelig. Da kan modellen bruke søk eller andre verktøy for å hente informasjon før den svarer.
I systemer som bruker RAG, Retrieval-Augmented Generation, skjer denne innhentingen som en del av arbeidsflyten. Systemet finner relevante utdrag i en dokumentsamling og legger dem inn i konteksten. Modellen svarer med utdragene foran seg.
Det fungerer dårlig hvis systemet henter en utdatert versjon eller et dokument som bare delvis gjelder spørsmålet. Modellen kan ikke nødvendigvis se at den har fått feil materiale.
Da kan modellen gi et ryddig svar med en ekte kilde, og likevel bomme på oppgaven.
Jeg ville derfor behandlet innhenting og besvaring som to trinn som begge må kunne feile. Først undersøker systemet om materialet er relevant og oppdatert for spørsmålet. Så forsøker det å svare. Mangler grunnlaget, må det kunne søke på nytt, be om avklaring eller melde at opplysningen ikke ble funnet.
En kildehenvisning er nyttig først når du har sjekket hva den støtter. At en lenke åpner en ekte nettside, er bare begynnelsen.
Kontroller påstandene hver for seg
Du kan også bruke modellen til å lage kontrollspørsmål til et utkast. Finnes kilden det henvises til? Står tallet faktisk der? Støtter sitatet påstanden?
Metoden Chain-of-Verification bygger på dette. Modellen lager først et svar, deretter spørsmål som kan kontrollere innholdet. Spørsmålene besvares uavhengig av det første utkastet, før resultatene brukes til å lage et nytt svar. Dhuliawala og kolleger fant at metoden reduserte hallusinasjoner i oppgavene de testet. Studien fra ACL 2024.
Hvorfor skille ut kontrollen? Fordi en feil i utkastet ellers kan styre kontrollen av det samme utkastet. «Bekreft at økningen var 20 prosent» legger føringer som «Hvor stor var økningen ifølge rapporten?» ikke gjør. Still kontrollspørsmålet i en ny samtale med kilden tilgjengelig.
Dette kan fortsatt feile. Modellen kan overse den samme setningen to ganger. Derfor er kontroll mot kildematerialet mer verdifullt enn at modellen bare vurderer om sin egen tekst høres riktig ut.
Noen vanlige råd trenger litt nyansering
Du har sikkert sett systemprompter med formuleringer som «ikke hallusiner», «svar alltid korrekt» og «vær hundre prosent sikker».
Slike instrukser kan påvirke hvordan modellen svarer. Men de tilfører ikke de manglende opplysningene. Det er mer nyttig å si hvor den skal lete, hva som teller som støtte, og hva den skal gjøre hvis opplysningen ikke finnes.
Det samme gjelder når du ber om en konfidensscore:
Hvor sikker er du på svaret, fra 1 til 10?
Et svar på 9 er også generert tekst. Du kan ikke uten videre lese det som 90 prosent sannsynlighet for at påstanden er riktig. Xiong og kolleger fant at modellene de undersøkte ofte uttrykte for høy sikkerhet. De fant også metoder som forbedret vurderingene, så poenget er ikke at all måling av usikkerhet er ubrukelig. Poenget er at tallet må testes og kalibreres før du kan behandle det som en pålitelig måling. Studien, presentert på ICLR 2024.
Et annet vanlig råd er å be om korte svar. Det er ofte helt fint. Men pass på at modellen fortsatt får plass til å korrigere spørsmålet eller forklare hva som mangler. Giskard fant at instrukser om korthet svekket motstanden mot hallusinasjoner i flere av deres tester. Det er et resultat fra bestemte modeller og oppgaver, ikke en regel om at lange svar alltid er bedre. Phare-analysen.
Og «tenk grundigere»? Det kan hjelpe når oppgaven krever at modellen regner eller kombinerer opplysninger. Mangler selve faktagrunnlaget, kan resultatet likevel bli en grundigere forklaring bygget på feil antakelser.
Der feil får konsekvenser
Hvor mye kontroll du trenger, avhenger av hva svaret skal brukes til. Et forslag til en overskrift og en opplysning som skal inn i en viktig beslutning trenger ikke samme behandling.
Skal innholdet brukes videre som fakta, bør noen kontrollere de avgjørende påstandene. Navn, beløp, datoer og sitater er konkrete steder å begynne. Men også betydningen kan være feil. «Finansieringen skal avklares» og «finansieringen er avklart» bruker nesten de samme ordene og forteller to helt forskjellige ting.
En menneskelig kontroll hjelper heller ikke hvis personen bare leser teksten og synes den høres fornuftig ut. Kontrolløren må ha noe å sammenligne med, eller fagkunnskapen som trengs for å oppdage at noe skurrer.
For de som vil lese mer om forskningen, samler Alansari og Luqman årsaker, metoder for å oppdage feil og tiltak for å redusere dem i Large Language Models Hallucination: A Comprehensive Survey. Det er et større felt enn noen få prompteteknikker. Arbeidet omfatter treningsdata, trening, informasjonsinnhenting og kontroll av det ferdige svaret.
Før du bruker svaret videre
Et svar kan være detaljert og godt formulert lenge før det er godt dokumentert. Det er lett å glemme når modellen treffer bra mange ganger på rad.
Gi modellen relevant materiale. La manglende informasjon være et gyldig resultat. Bruk kontrollspørsmål til å finne påstandene som må sjekkes, og gå til kildene når svaret skal brukes til noe viktig.
Neste gang du får et navn, et tall eller et sitat du skal bruke videre, stopp opp ved akkurat den opplysningen. Finn ut hvor den kommer fra. Det er ofte der du oppdager at en ellers god tekst har tatt seg noen friheter.
See you in the next one!
Først publisert .
← Alle artikler