Sammendrag
Kan jeg representere tekst med et lite antall forståelige egenskaper og fortsatt finne relevante dokumenter? I denne studien brukte jeg JEV til å vurdere 34 faste egenskaper ved hver av de 13 083 meldingene i BANKING77. De 10 003 treningsmeldingene ble søkekorpus, og de 3 080 testmeldingene ble brukt som søk. Et treff ble regnet som relevant når det hadde samme intensjonsetikett som søket.
Cosinuslikhet mellom egenskapsvektorene ga riktig første treff i 83,67 % av søkene, mot 80,10 % for BM25. Forskjellen var 3,57 prosentpoeng, med et paret 95 % bootstrap-intervall på 1,92–5,26 prosentpoeng. Vanlig og vektet dot product ga vesentlig svakere resultater: henholdsvis 25,97 % og 28,02 %.
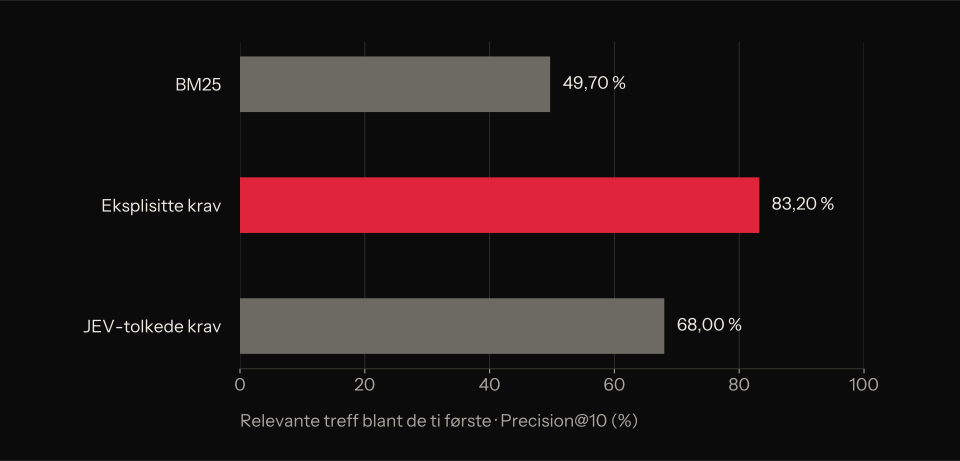
I en separat evaluering av 100 søkeformuleringer fordelt på 25 semantiske grupper ga eksplisitt angitte egenskapskrav en Precision@10 på 83,20 %. Når JEV selv tolket søket til krav, var resultatet 68,00 %, mot 49,70 % for BM25. Denne evalueringen bruker relevans avledet fra datasettets etiketter, ikke uavhengige menneskelige vurderinger av hvert treff.
Resultatene viser at et lite, navngitt egenskapsrom kan bevare nyttig informasjon for søk i dette domenet. De viser også at representasjonen og rangeringsmetoden må vurderes sammen. Studien sammenligner ikke med en ordinær embeddingmodell og dokumenterer derfor ikke at jevbeddings kan erstatte slike modeller generelt.
Hva om tallene hadde navn?
Se for deg at du skal finne meldinger om kort som ikke har kommet frem. Et søkesystem returnerer en liste. Det øverste treffet ser relevant ut, men hvorfor ligger akkurat det der?
Tekster kan sammenlignes ved å representere dem som tallrekker. Jeg hadde lyst til å teste hvor godt søket ville fungere hvis jeg bestemte på forhånd hva hvert tall skulle bety.
Én dimensjon kan beskrive om meldingen handler om et betalingskort. En annen om kortet ikke er mottatt. En tredje om kunden spør etter status. Da kan jeg undersøke hvilke egenskaper som trakk et dokument opp, og hvilke som trakk det ned.
Det var tanken med å teste Jevbeddings. Jeg lot JEV vurdere tekstene ut fra et fast sett med spørsmål, og brukte svarene som vektorer å søke i. Så prøvde jeg noen ulike måter å sammenligne dem på for å se hvor godt det fungerte.
Det jeg likte med dette oppsettet, var at jeg kunne undersøke hvilke egenskaper som påvirket et treff. Selve modellvurderingen var fortsatt noe jeg måtte stole på eller kontrollere mot teksten, men bidragene til rangeringen kunne jeg regne meg frem til.
Jeg ville særlig undersøke tre ting: Hvor mye informasjon bevarer 34 slike egenskaper? Hvordan bør vektorene sammenlignes? Og hva skjer når jeg bruker egenskapene som eksplisitte søkekrav, med mulighet for å nedprioritere eller filtrere bort bestemte treff?
Fra melding til 34 tall
Jeg definerte fire grupper med egenskaper:
| Gruppe | Antall | Eksempler |
|---|---|---|
| Hva meldingen handler om | 10 | Kort, kontanter, overføring, identitetskontroll |
| Hendelse eller problem | 12 | Mislykket betaling, ekstra gebyr, kort ikke mottatt |
| Hva kunden ønsker | 6 | Kansellere, få refusjon, endre noe, få status |
| Tilstand | 6 | Venter, avvist, mangler, feil, ukjent, utløpt |
For hver tekst stilte jeg de samme 34 spørsmålene til jev-1.13.0. Hvert svar er en verdi mellom 0 og 1. Til sammen danner svarene en vektor med 34 tall.
Tenk på hvert tall som modellens vurdering av hvor godt teksten oppfyller den tilhørende egenskapen. Jeg har ikke menneskelige fasitverdier for alle egenskapene. Derfor tolker jeg ikke for eksempel 0,9 som en dokumentert 90 % sannsynlighet for at egenskapen er riktig.
Her er seks av verdiene for en faktisk testmelding:
I still have not received my new card, I ordered over a week ago.
| Egenskap | Verdi |
|---|---|
| Handler om kort | 0,99 |
| Kort ikke mottatt | 0,98 |
| Noe mangler | 0,98 |
| Ønsker status | 0,97 |
| Venter på at noe fullføres | 0,97 |
| Noe er feil | 0,78 |
Jeg kan lese representasjonen og vurdere om den virker rimelig. Den siste verdien er også en påminnelse om at en tydelig merkelapp ikke automatisk gir en entydig vurdering. Betyr en forsinkelse at noe er «feil»? Definisjonen og modellens tolkning avgjør hvilke tall jeg får.
Alle definisjonene og de nøyaktige spørsmålene finnes i egenskapsskjemaet.
Hvordan jeg satte opp testen
Jeg brukte BANKING77, introdusert av Casanueva og kolleger i 2020. Datasettet består av engelske bankhenvendelser fordelt på 77 kategorier.
Jeg fulgte den offisielle delingen: 10 003 meldinger som dokumenter og 3 080 som søk. Hvert søk ble sammenlignet med alle dokumentene. Kategoriene ble brukt til å vurdere treffene, ikke til å trene en klassifikator.
JEV fikk bare meldingsteksten og de faste egenskapsspørsmålene, uten kategorinavn eller merkede eksempler. De 34 egenskapene var ikke omskrivinger av de 77 kategoriene, men skjemaet var laget for bankhenvendelser og hadde derfor noe tematisk overlapp.
Skjema og protokoll ble låst og kontrollsummert før testfilen ble hentet. Tilleggssøkene ble laget fra treningssettets kategorioversikt og låst før testresultatene ble undersøkt. Ingen parametere ble tilpasset testresultatene. Tidsstemplingen var lokal, ikke en offentlig forhåndsregistrering.
I hovedtesten ble søk og dokumenter vurdert på samme måte. En høy verdi betyr at egenskapen finnes i meldingen, ikke nødvendigvis at brukeren vil prioritere den. Senere testet jeg også eksplisitte søkekrav, som bruker tallene på en annen måte.
Fire måter å rangere på
Jeg sammenlignet tre måter å rangere JEV-vektorene på, i tillegg til BM25 på originalteksten. I formlene under er søkets tall og dokumentets tall.
Dot product: summer det som overlapper
Den enkleste beregningen multipliserer verdiene for hver egenskap og summerer bidragene:
Hvis både søket og dokumentet scorer høyt på «kort ikke mottatt», blir bidraget stort. Hvis én av dem scorer lavt, blir bidraget lite. Hver egenskap har sitt eget bidrag som jeg kan vise frem.
Et dokument med høye verdier på mange egenskaper kan få et fortrinn, selv om det ikke passer særlig presist til søket.
Cosinus: sammenlign retningen
Cosinuslikhet deler dot product på lengden til begge vektorene:
Da teller mønsteret i egenskapene mer enn hvor høye verdiene er samlet. Lengde betyr her størrelsen på vektoren, ikke antall ord i teksten.
Et konstruert eksempel: Søket er [1; 0,5; 0], dokument A er [0,9; 0,45; 0], og B er [1; 1; 1]. Dot product gir A 1,125 og B 1,5. Med cosinus får A 1 og B omtrent 0,775. A vinner fordi egenskapene har samme innbyrdes forhold som i søket.
Cosinus skiller dermed ikke mellom svake og sterke verdier som har samme forhold. Om det er ønskelig, avhenger av oppgaven.
Samme vektorer. Ulik vinner.
Søket er q = [1; 0,5; 0]. Bytt beregning og se hva som skjer med de to dokumentene.
[0,9; 0,45; 0]
[1; 1; 1]
B vinner med dot product.
Vektet relevans: la sjeldne egenskaper telle mer
Noen egenskaper forekommer i mange dokumenter. Jeg testet derfor også en variant av dot product der sjeldne egenskaper teller mer. Vektene ble beregnet bare fra treningsdokumentene, med 0,5 som terskel for at en egenskap er til stede.
Scoren ble normalisert med en verdi som er lik for alle dokumenter i samme søk. Det endrer ikke rekkefølgen: Forskjellen fra vanlig dot product kommer fra egenskapsvektene. Den nøyaktige beregningen finnes i rangeringskoden.
BM25: en referanse basert på ordene
BM25 søker direkte i teksten, gir sjeldne ord større vekt og justerer for dokumentlengde. Jeg brukte innstillingene k1 = 1,2 og b = 0,75. Teksten ble gjort om til små bokstaver og delt i ord og tall, uten stemming eller fjerning av stoppord.
Det gir meg en konkret referanse: Hvor mye får jeg igjen for modellvurderingene, sammenlignet med å søke direkte i ordene?
Hva teller som et godt treff?
Hovedmålet var Top-1: andelen søk der det første dokumentet hadde samme kategori som testmeldingen. Jeg målte også om minst ett av de fem første treffene var relevant, kalt Hit@5.
Hit@5 er ikke det samme som Recall@5. Hvis korpuset har 100 relevante dokumenter og jeg finner fire av dem blant de fem første, er Precision@5 lik 80 %, Recall@5 lik 4 %, og Hit@5 lik 1 for dette søket.
Jeg målte også MRR, som belønner at det første relevante treffet kommer tidlig i rangeringen, og nDCG@10, som vurderer plasseringen av relevante treff blant de ti første. Relevans ble i alle tilfeller bestemt av kategorien i datasettet.
Resultatet: rangeringen gjorde stor forskjell

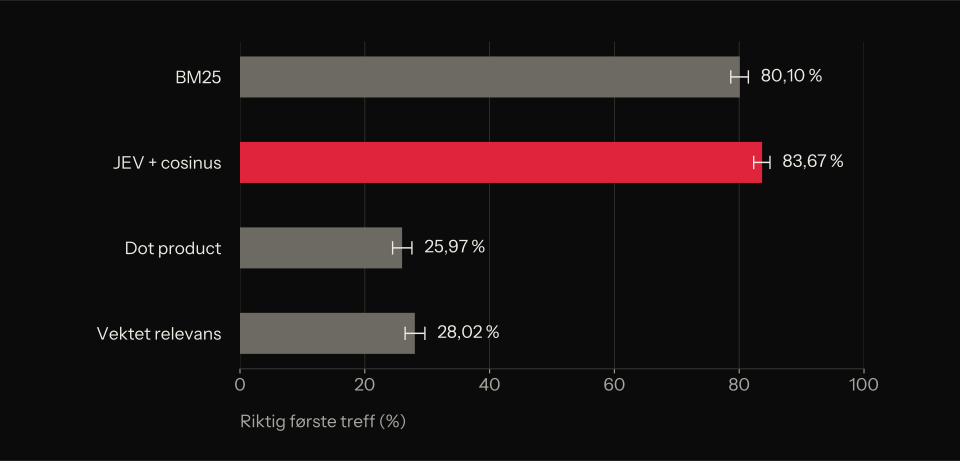
| Metode | Top-1 | Hit@5 | Precision@5 | Recall@5 | MRR | nDCG@10 |
|---|---|---|---|---|---|---|
| BM25 | 80,10 % | 93,80 % | 70,34 % | 2,93 % | 0,8611 | 0,6769 |
| JEV + cosinus | 83,67 % | 93,60 % | 78,44 % | 3,22 % | 0,8802 | 0,7678 |
| JEV + dot product | 25,97 % | 49,61 % | 29,99 % | 1,08 % | 0,3715 | 0,3025 |
| JEV + vektet relevans | 28,02 % | 49,81 % | 31,86 % | 1,16 % | 0,3863 | 0,3203 |
Alle tre vektormetodene brukte nøyaktig de samme lagrede JEV-vurderingene. Forskjellen mellom dem kommer fra beregningen som rangerer dokumentene.
Cosinus ga 3,57 prosentpoeng høyere Top-1 enn BM25. Jeg beregnet forskjellen med 2 000 parede bootstrap-trekk: I hvert trekk brukte begge metodene de samme uttrukne testmeldingene. Intervallet var 1,92–5,26 prosentpoeng. Jeg gjorde ingen korreksjon for flere sammenligninger. Intervallet beskriver variasjon over meldingene i dette benchmarksettet, ikke sikkerheten for at samme forbedring vil oppstå i et annet domene.
BM25 hadde marginalt høyere Hit@5. Cosinus vant altså ikke på alle mål, men plasserte oftere et relevant dokument aller først og hadde høyere presisjon blant de fem første.
Jeg kontrollerte også overlapp mellom trenings- og testtekst. Etter normalisering av store bokstaver og mellomrom fant jeg sju testmeldinger som fantes i treningssettet. Uten disse var Top-1 83,63 % for cosinus og 80,05 % for BM25. Hovedbildet var dermed det samme.
Hvorfor gikk dot product så dårlig?

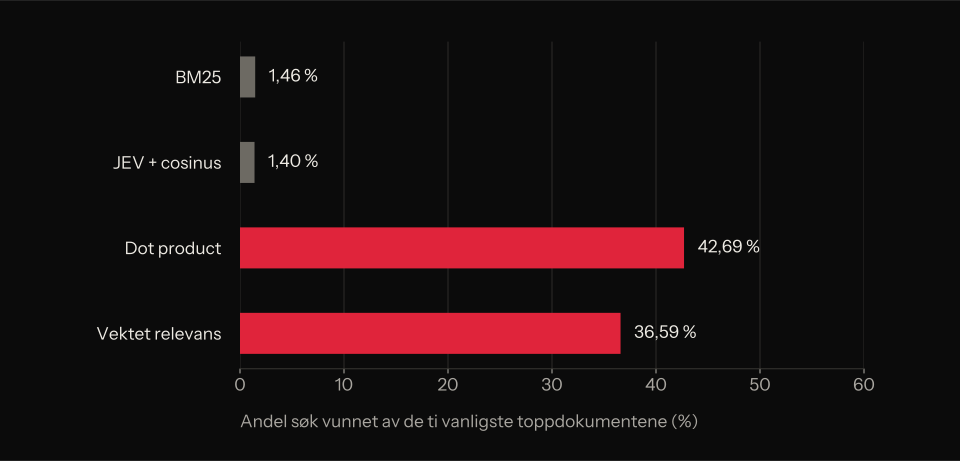
Etter hovedtesten undersøkte jeg hvilke dokumenter som stadig havnet øverst. Jeg endret ikke metoden på bakgrunn av analysen.
| Metode | Ulike dokumenter på førsteplass | Andel søk vunnet av de ti vanligste vinnerne | Sterke egenskaper hos vinneren, i snitt |
|---|---|---|---|
| BM25 | 2 383 | 1,46 % | 4,69 |
| Cosinus | 2 456 | 1,40 % | 4,75 |
| Dot product | 232 | 42,69 % | 10,39 |
| Vektet relevans | 255 | 36,59 % | 10,05 |
En «sterk egenskap» betyr her en verdi på minst 0,5. Et gjennomsnittlig dokument hadde 4,96 slike egenskaper.
Med dot product vant bare ti dokumenter nesten 43 % av alle søk. Vinnerne hadde også langt flere sterke egenskaper enn det gjennomsnittlige dokumentet. Det passer med svakheten jeg så i formelen: Høye verdier på mange egenskaper kan gi et dokument et stort fortrinn.
Dette er en beskrivende sammenheng, ikke et isolert bevis på årsaken til hver feil. Men den gir en konkret forklaring å undersøke videre. Vektet relevans reduserte problemet noe, men var langt unna cosinus i denne oppgaven.
Jeg kan også se hva som skjedde i ett feiltreff. Søket «How do I locate my card?» hadde fasitkategorien card_arrival. Vektet relevans hentet en melding om et kort som var mistet på en restaurant, med bekymring for uautorisert bruk.
De største råbidragene kom fra «kort ikke mottatt» med 2,94, «sikkerhetsbekymring» med 1,04 og «handler om kort» med 0,85. Jeg kan dermed se hvilke vurderinger som førte til treffet. Spørsmålet i seg selv er også tvetydig uten mer kontekst. Etiketten gir meg en konsistent evalueringsregel, men er ikke nødvendigvis den eneste rimelige tolkningen av hver enkelt melding.
Når søket beskriver det jeg vil finne

Hovedtesten sammenlignet én kundemelding med andre kundemeldinger. Men et søk kan også være en bestilling: Finn problemer med overføringer. Finn gebyrer. Finn kort som ikke har kommet frem.
Her kan jeg angi hvilke egenskaper som skal telle, i stedet for å behandle søket som en ny kundemelding. Jeg laget 25 semantiske grupper med fire formuleringer hver, totalt 100 søk. For hver gruppe definerte jeg både relevante kategorier og eksplisitte egenskapsvekter.
For søk om kortlevering var kravene for eksempel vekt 1 på «handler om kort», vekt 1 på «kort ikke mottatt» og vekt 0,5 på «ønsker status». De samme eksplisitte kravene ble brukt for alle fire formuleringene i gruppen.
Jeg sammenlignet BM25, de manuelt angitte kravene og en variant der JEV tolket den naturlige søketeksten til krav.
| Metode | Precision@10 | Hit@10 | MRR | nDCG@10 |
|---|---|---|---|---|
| BM25 | 49,70 % | 92,00 % | 0,6823 | 0,5110 |
| Eksplisitte egenskapskrav | 83,20 % | 92,00 % | 0,8854 | 0,8372 |
| JEV-tolkede søkekrav | 68,00 % | 83,00 % | 0,7000 | 0,6721 |
Forskjellen mellom de to siste radene viser hvorfor tolkning og rangering bør vurderes hver for seg. Med eksplisitte krav vet jeg hvilke vekter søket skal bruke. Med naturlig språk må modellen også finne frem til disse. Seks av de 100 tolkede søkene ble stoppet for gjennomgang på grunn av ukjente konsepter, usikre krav eller manglende aktive krav. De teller som null treff i resultatene.
Dette er en avgrenset test. Relevans ble bestemt gjennom grupper av eksisterende kategorier, og egenskapskravene ble laget som del av samme oppgaveoppsett. Jeg har ikke uavhengige menneskelige vurderinger av alle søk og dokumenter. De fire formuleringene i hver gruppe er dessuten nært beslektet. Resultatet representerer 25 konstruerte søkeoppgaver, ikke 100 uavhengige informasjonsbehov.
Kan jeg si hva jeg ikke vil ha?
Navngitte egenskaper gjør det mulig å uttrykke negative preferanser direkte. Hvis en egenskap skal trekke ned, kan jeg gi den en negativ vekt.
Jo sterkere negativ vekt, desto mer trekkes dokumenter med denne egenskapen ned. Et bestemt dokument kan ikke få høyere råscore når straffen øker. Det garanterer likevel ikke en bedre treffliste: Dokumentene får ulike trekk, og modellens vurderinger kan være feil.
Et hardt filter fjerner i stedet alle dokumenter som bryter en betingelse, for eksempel at en uønsket egenskap har verdi over 0,2.
Jeg testet åtte tilfeller med straffestyrke 0, 0,25, 0,5 og 1, samt hardt filter på 0,2. Ingen dokumenter brøt de numeriske filterkravene, og ingen råscorer økte når straffen økte.
Den semantiske effekten var mer blandet. I søket etter ukjente betalinger uten kontantuttak falt andelen uønskede kategorier blant de ti første fra 30 % til 0 % med sterk straff. Det harde filteret slapp fortsatt gjennom 10 %. I to andre tilfeller falt presisjonen for ønskede treff fra henholdsvis 90 % til 50 % og fra 100 % til 40 % med sterk straff.
Sju av åtte tilfeller hadde dessuten ingen uønskede kategorier blant de ti første før jeg la på straff. Disse tilfellene gir lite grunnlag for å måle forbedring. Testen dokumenterer at reglene virker på tallene, men gir begrenset støtte for hvor godt de fjerner det brukeren faktisk ønsker å unngå.
Hvilke egenskaper bidro?

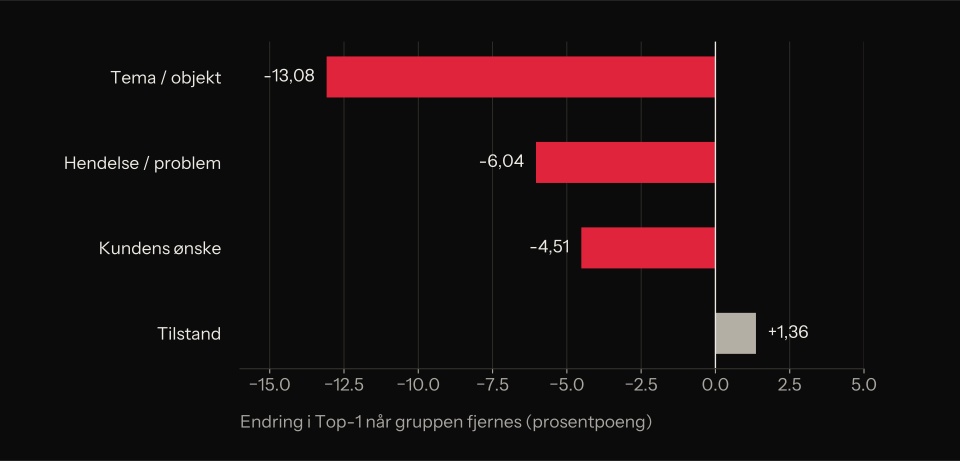
Jeg fjernet én egenskap om gangen og én hel gruppe om gangen. Dette kalles en ablasjon: Jeg undersøker hva som skjer når en del av systemet tas bort. Analysen ble gjort for vektet relevans, med de samme modellvurderingene og uendrede vekter for egenskapene som sto igjen.
| Fjernet gruppe | Top-1 | Endring fra full vektet metode |
|---|---|---|
| Ingen | 28,02 % | — |
| Hva meldingen handler om | 14,94 % | −13,08 prosentpoeng |
| Hendelse eller problem | 21,98 % | −6,04 prosentpoeng |
| Hva kunden ønsker | 23,51 % | −4,51 prosentpoeng |
| Tilstand | 29,38 % | +1,36 prosentpoeng |
Egenskapene som beskriver hva meldingen handler om, hadde størst samlet utslag. Å fjerne tilstandsgruppen ga derimot en liten forbedring på Top-1. Flere egenskaper var altså ikke automatisk bedre med denne rangeringsmetoden.
Dette sier ikke hvilke grupper som er viktigst for cosinus. Det sier heller ikke at en egenskap uten stor ablasjonseffekt er unyttig; en annen egenskap kan inneholde mye av den samme informasjonen. Alle 38 ablasjonene er dokumentert, men de ble ikke brukt til å velge et nytt skjema og presentere det samme testsettet som en ny, urørt test.
Kostnad og etterprøvbarhet
Studien omfattet 13 183 fullførte logiske modellkall: ett for hver av de 13 083 meldingene og 100 for tolkning av tilleggssøk. Ett kall krevde et ekstra forsøk. Vektorene ble gjenbrukt til de ulike rangeringsmetodene, kontrolltestene og ablasjonene.
Jevbeddings-prosjektet kostet totalt USD 2,0765, altså omtrent 2,08 dollar. Kostnadsgrunnlaget og dokumentasjonen følger forsøksmaterialet.
Alle tekstfingeravtrykk og lagrede egenskapsverdier for de 13 083 meldingene ble kontrollert. En separat fullsortering for 31 faste testsøk ga samme topp ti og rangering av første relevante treff i alle 124 metodekontroller. De 25 automatiske programtestene passerte også.
Datakilden er låst til commit 57ec275d8078af65b7731c2a98be812d844a6d6b. Kode, protokoll, spørsmål, vekter, resultater per søk og lagrede modellvurderinger følger reproduksjonspakken. Det gjør det mulig å beregne rangeringene på nytt uten nye modellkall. En ny ekstraksjon mot API-et er et eget forsøk; jeg garanterer ikke identiske svar fra en ekstern tjeneste over tid.
Hva studien gir grunnlag for
I dette forsøket fungerte 34 navngitte egenskaper ganske godt på BANKING77 når jeg brukte cosinuslikhet. Da ble det første treffet oftere riktig enn med BM25. Med dot product gjorde de samme verdiene det vesentlig dårligere. Det var noe av det tydeligste jeg fikk ut av testen: Valget av rangeringsmetode hadde mye å si, selv om egenskapene var de samme.
Tilleggssøkene viser også at eksplisitte egenskapskrav kan være nyttige i dette oppsettet. Samtidig svekkes resultatene når naturlig språk først må oversettes til krav, og de negative kontrollene viser at en numerisk korrekt regel fortsatt kan gi feil treff.
Det gjenstår flere ubesvarte spørsmål. Jeg testet ett engelskspråklig bankdatasett. Jeg vet ikke om JEV har sett BANKING77 tidligere. Egenskapene er ikke kalibrert mot menneskelige vurderinger, og søkeoppgavene utenfor hovedtesten er konstruert fra kategoriene. Jeg kjørte heller ingen ordinær embeddingmodell som sammenligningsgrunnlag.
En videre studie bør derfor teste samme idé på nye meldinger, med uavhengige vurderinger av både egenskaper og relevans, og med en embeddingmodell som referanse. Eventuelle endringer som gjøres etter denne studien, må vurderes på nye testdata.
For min del ga forsøket et konkret resultat å jobbe videre med. Jeg kunne følge et treff ned til bidragene fra hver egenskap, og én av rangeringsmetodene fungerte godt på dette datasettet. Jeg kunne også se hvor oppsettet bommet. Om det fungerer like godt på andre typer tekst, gjenstår å teste.
Kilder og materiale
Datagrunnlag og resultater følger pakken. Dokumentasjonsoversikten forklarer hvordan beregningene kan etterprøves uten nye API-kall, og hvilke begrensninger lokale kalllogger og tidsstempler har som bevis på selve kjøringen.
- Casanueva, I., Temčinas, T., Gerz, D., Henderson, M. og Vulić, I. (2020). Efficient Intent Detection with Dual Sentence Encoders. BANKING77-datasett og lisens. Datasettet er brukt under CC-BY-4.0; originaletikettene er beholdt.
- TypeSafe. JEV API og modellreferanse. Modell i forsøket:
jev-1.13.0. - jevbeddings. Låst protokoll, implementeringspresiseringer, kjøreinstruksjoner og egenskapsskjema.
- jevbeddings. Teknisk resultatrapport, maskinlesbare resultater, bidrag til konkrete treff, etteranalyse av vinnerdokumenter og kontrollberegninger.
- Komplett reproduksjonspakke.
Regn på det selv.
Forskningspakken inneholder kode, datasett, lagrede modellvurderinger og resultater per søk. Beregningene kan kjøres på nytt uten API-nøkkel.
Last ned hele forsøket · 5,8 MB ↓Kode, data og reproduksjon på GitHub ↗
Hva dokumentasjonen beviser – og ikke beviser
Alle resultater (JSON) · Hovedresultater (CSV) · Studien (Markdown)